
一般的 Vector 能夠表達語意,但對於一些專有名詞比較苦手,所以需要一些能夠準確定位關鍵字的搜尋方式,兩者搭配使用希望能找出語意接近且命中關鍵詞的資料。
一般的 Embedding Model 回傳的多是 Dense Vector,幾乎每一個維度都有值,而還有另外一種 Vector 是 Sparse Vector,Sparse Vector 通常具有很高的維度,但只有少數維度是非零值。
直觀來看,Dense Vector 會把一段文字的語意分散編碼在整個 Vector 中,因此很適合判斷「整體意思像不像」;Sparse Vector 則只有少數維度代表某些重要的 token 或特徵,因此比較擅長捕捉「哪些關鍵詞或特徵很重要」。
那如何產出 Sparse Vector 呢?
BM25 是一個基於傳統的關鍵字統計方法,用來做全文搜尋的 ranking algorithm,它主要看三件事,公式是: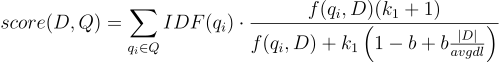
其中一個很重要的概念是 TF 並不是越高就無限線性加分。
假設 Query 裡有 Milvus,一篇文章出現 2 次確實通常會比只出現 1 次更 relevant,但如果另一篇文章出現 100 次,也不應該因此得到 100 倍的分數,所以 BM25 會讓 TF 的影響逐漸飽和。k1 就是在控制這個飽和速度。k1 越大,Term Frequency 對分數的影響可以延續得更久;Milvus 預設為 1.2。
另一個問題是文件長度。假設一篇文章有 100 個字,其中出現 3 次 Milvus;另一篇文章有 10000 個字,也出現 3 次 Milvus,直覺上前者可能跟 Milvus 更相關。因此 BM25 會透過:
來做文件長度 normalization,而 b 就是控制這件事的強度。當 b = 0 代表完全不考慮文件長度;當 b = 1則會完整套用文件長度 normalization。Milvus 預設為 0.75。
所以 BM25 可以簡單理解成:
關鍵字有沒有出現
        +
出現越多通常越重要,但不能無限加分
        +
越稀有的詞越重要
        +
避免長文章單純因為字很多而吃香
        ↓
BM25 relevance score
回到 Sparse Vector,對於每個文件來說,他們的 Sparse Vector 基本上就是 TF,但還會需要另外維護一個全域的 DF,之後算相似度的時候就套用 BM25 公式計算 relevance score 並排序。
在 Milvus 中,我們不用自己去計算 TF 後再存入 Sparse Vector,而是要在 text field 啟用 analyzer,接著掛上一個 BM25 的 function,Milvus 就會在每次插入資料時幫我們自動產出 Sparse Vector,並同時維護一份 DF、平均文件長度 avgdl 等 corpus-level statistics,流程大概是:
Text
 ↓
Milvus Analyzer
 ↓
BM25 Function
 ↓
Sparse Vector
 ↓
Sparse Inverted Index
 ↓
BM25 Search
要特別注意 BM25 Full-Text Search 目前不支援 Lite,所以要改用 Milvus Standalone、Distributed、Zilliz Cloud。
之前直接用 create_collection() 只能幫我們快速建一個主要的 dense vector field,想要建 sparse vector 欄位需要自己定義 schema:
from pymilvus import MilvusClient, DataType, Function, FunctionType

milvus_client = MilvusClient(uri="http://localhost:19530")

schema = milvus_client.create_schema(
    auto_id=True,
    enable_dynamic_field=True
)

schema.add_field(
    field_name="id",
    datatype=DataType.INT64,
    is_primary=True
)

# text 的 enable_analyzer 要設為 True
schema.add_field(
    field_name="text",
    datatype=DataType.VARCHAR,
    max_length=5000,
    enable_analyzer=True,
)

schema.add_field(
    field_name="dense_vector",
    datatype=DataType.FLOAT_VECTOR,
    dim=1024
)

# sparse vector 不需要定義 dimension
schema.add_field(
    field_name="sparse_vector",
    datatype=DataType.SPARSE_FLOAT_VECTOR
)

# 掛上 BM25 function
bm25_function = Function(
    name="text_bm25",
    input_field_names=["text"],
    output_field_names=["sparse_vector"],
    function_type=FunctionType.BM25,
)
schema.add_function(bm25_function)
除了傳統的關鍵字統計方法外,另外一種是讓神經網路直接學出 Sparse Vector,舉例來說,我們可以用 Milvus 的 BGEM3EmbeddingFunction 來同時做 Dense 和 Sparse Embedding:
from pymilvus.model.hybrid import BGEM3EmbeddingFunction

ef = BGEM3EmbeddingFunction(use_fp16=False, device="cpu")
dense_dim = ef.dim["dense"]
sparse_dim = ef.dim["sparse"]

print(dense_dim)    # 1024
print(sparse_dim)   # 250002
不論是不是用 BGE-M3,在 Milvus 中用自己的 Sparse Vector 的流程:
Text
 ↓
BGE-M3 (自己做 Embedding)
 ↓
Sparse Vector (自己插入)
 ↓
Sparse Inverted Index
 ↓
IP Search
Milvus 支援用 sparse matrix、dictionary 或 (index, value) 作為 Sparse Vector 的輸入格式,不論用哪種 Milvus 輸入,所有 Sparse Vector 都會被儲存為同一種資料型態 SPARSE_FLOAT_VECTOR,SPARSE_FLOAT_VECTOR 不需要定義 dimension,因為背後邏輯是直接存非 0 的維度,像這樣:
{
    1234: 0.82,
    8372: 0.31,
    19402: 0.66
}
在 Milvus 中所有 Vector Field 都一定要有 Index 才能真的被查詢。 (雖然對 Milvus Lite 來說根本只能用 FLAT,就算設定別種 Index,背後都還是 FLAT。)
對於 Sparse Vector 來說,Milvus 提供的 Index 只有一種,就是 SPARSE_INVERTED_INDEX,概念上就是傳統的 Inverted Index,去存每個維度有哪些資料。
如果是用 BM25,那要設定為 metric_type="BM25";如果是自己做 Embedding 然後插入 Sparse Vector,那通常會設定 metric_type="IP",原因是 Learned Sparse Embedding 的每個非零維度都代表某個有權重的 token 或特徵,而 Inner Product 剛好可以把 Query 和 Document 在相同維度上的權重相乘後加總,直接當成 relevance score。
資料:
A → [(10, 0.8), (25, 0.3)]
B → [(10, 0.5), (40, 0.9)]
C → [(25, 0.7), (40, 0.2)]
Inverted Index:
dimension 10
→ A: 0.8
→ B: 0.5

dimension 25
→ A: 0.3
→ C: 0.7

dimension 40
→ B: 0.9
→ C: 0.2
Create Index and Collection:
index_params = milvus_client.prepare_index_params()

index_params.add_index(
    field_name="dense_vector",
    index_type="HNSW",
    metric_type="COSINE",
    params={
        "M": 16,
        "efConstruction": 100
    }
)

# 如果是用 BM25,metric_type="BM25"
# 如果是自己傳 sparse Vector,metric_type="IP"
index_params.add_index(
    field_name="sparse_vector",
    index_type="SPARSE_INVERTED_INDEX",
    metric_type="BM25"
)

milvus_client.create_collection(
    collection_name="sparse_vector_practice",
    schema=schema,
    index_params=index_params
)
如果是用 BM25 的話,data 直接丟文字就好。
milvus_client.search(
    collection_name="sparse_vector_practice",
    data=["what is information retrieval?"],
    anns_field="sparse_vector",
    limit=3,
    output_fields=["text"]
)
如果是用自己的 Sparse Vector,那 data 的格式要傳入:sparse matrix、dictionary 或 (index, value),同可插入的格式。
milvus_client.search(
    collection_name="sparse_vector_practice",
    data=query_sparse,
    anns_field="sparse_vector",
    limit=3,
    output_fields=["text"]
Retrieval 很難,找工作也是。


 iThome鐵人賽
 看影片追技術